Definición
La Universidad Alfonso X el Sabio lo define (artículo consultado el 09/09/2026) como «una disciplina del campo de la IA que se centra en el desarrollo de algoritmos y modelos estadísticos que permiten a los sistemas informáticos mejorar su rendimiento en una tarea específica a través de la experiencia». La palabra clave es experiencia: el sistema mejora con más datos, no con más líneas de código.
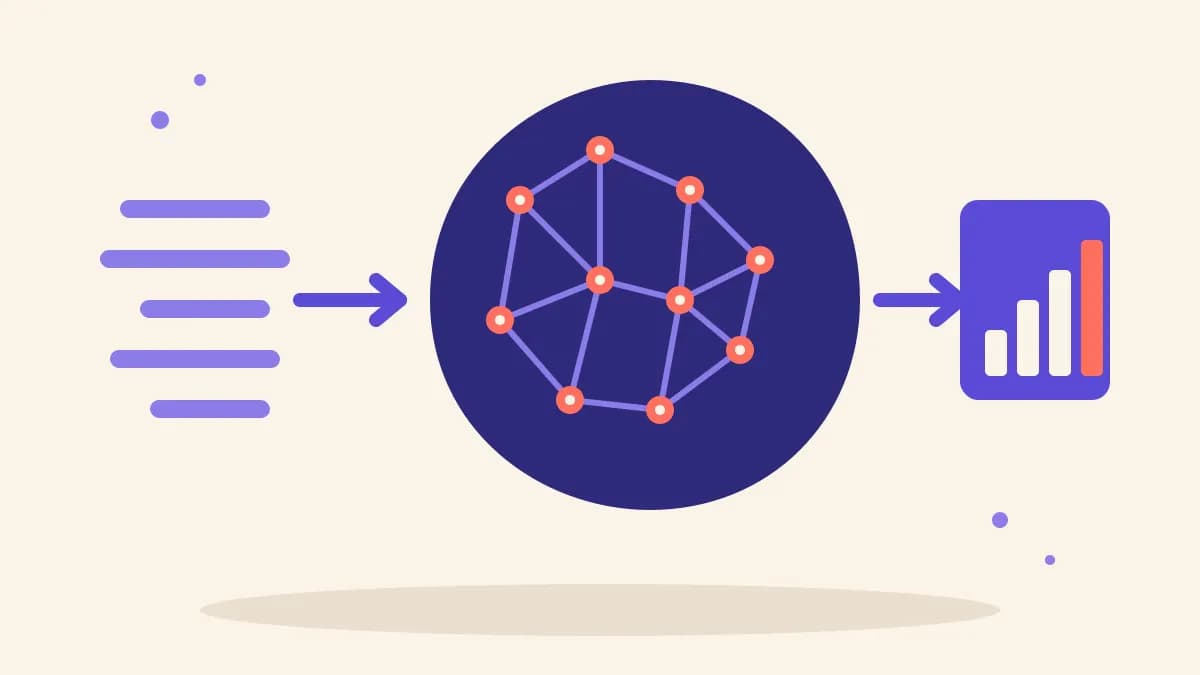
Un modelo de machine learning tiene tres ingredientes: datos históricos (lo que pasó), un algoritmo (la forma de encontrar patrones) y una tarea (lo que se quiere predecir o clasificar). El resultado es un modelo entrenado que, ante un caso nuevo, devuelve una predicción con cierto nivel de confianza.
Machine learning, inteligencia artificial y deep learning
Se confunden con frecuencia:
- Inteligencia artificial es el campo amplio: sistemas que realizan tareas que asociamos con inteligencia humana (entender lenguaje, reconocer imágenes, decidir).
- Machine learning es una forma de lograr IA: aprender de datos en lugar de seguir reglas fijas. Casi toda la IA útil en empresas hoy es machine learning.
- Deep learning es un tipo de machine learning que usa redes neuronales con muchas capas para modelar relaciones complejas; es lo que hay detrás del reconocimiento de imágenes, la voz y los modelos de lenguaje como los asistentes conversacionales.
Para una empresa, la distinción práctica es esta: si tu problema es predecir o clasificar a partir de datos tabulares (ventas, clientes, transacciones), el machine learning «clásico» suele bastar y es más barato; si involucra imágenes, audio o texto libre, entra el deep learning. En avances tecnológicos de 2026 repasamos qué tecnologías están madurando.
Tipos de machine learning
Aprendizaje supervisado
Se entrena con datos etiquetados, es decir, con la respuesta correcta incluida. La fuente citada menciona como aplicaciones la clasificación de spam, la predicción de precios y los diagnósticos médicos. Es el tipo más usado en negocios: predecir si un cliente pagará, cuánto venderá una tienda la próxima semana o si una transacción es fraude.
Aprendizaje no supervisado
Trabaja con datos sin etiquetar y descubre estructuras ocultas. Los usos típicos son la segmentación de clientes (agrupar por comportamiento, no por edad) y la detección de anomalías (consumos, accesos o pagos fuera de lo normal).
Aprendizaje semisupervisado
Combina pocos datos etiquetados con muchos sin etiquetar. Útil cuando etiquetar es caro: por ejemplo, clasificar miles de reclamos cuando solo un equipo pequeño puede revisar unos cientos.
Aprendizaje por refuerzo
El sistema aprende probando acciones y recibiendo recompensas o penalizaciones. Es la base de sistemas que optimizan decisiones secuenciales, como la asignación dinámica de precios o rutas. En empresas medianas es menos común que los anteriores.
Ejemplos de uso en empresas
La fuente citada menciona mantenimiento predictivo, detección de fraudes, personalización de experiencias y optimización de procesos. Aterrizados a casos que vemos en negocios peruanos:
- Ecommerce: recomendación de productos, predicción de demanda por SKU para no quedarse sin stock, detección de pedidos fraudulentos. La personalización aparece entre las tendencias del comercio electrónico en Latinoamérica.
- Servicios y suscripciones: predicción de baja (churn) para actuar antes de que el cliente se vaya.
- Finanzas y cobranza: puntaje de riesgo de pago, priorización de gestiones de cobranza.
- Marketing: segmentación por comportamiento y optimización de campañas; las plataformas de anuncios ya lo usan por dentro, como explicamos en publicidad segmentada: errores que afectan el ROI.
- Operaciones: pronóstico de ventas por sede, planificación de personal, mantenimiento de flotas o equipos; es el siguiente paso después de automatizar los procesos básicos.
- Atención al cliente: clasificación automática de tickets y respuestas sugeridas.
Ninguno de estos casos exige un laboratorio de investigación. Exige datos limpios, un objetivo claro y una forma de integrar la predicción en el proceso real.
Qué necesita una empresa para aplicarlo
- Datos suficientes y ordenados. Sin historial no hay aprendizaje. Un data warehouse o al menos una base de datos consolidada es el prerrequisito.
- Una pregunta de negocio concreta. «Quiero usar IA» no es un proyecto; «quiero saber qué clientes dejarán de comprar el próximo trimestre» sí.
- Un punto de integración. La predicción debe llegar a alguien o a algún sistema que actúe: el CRM, el sistema de pedidos, el tablero del gerente. Si se queda en un informe, no cambia nada. La gestión basada en datos es el marco.
- Medición. Comparar lo que el modelo predijo con lo que pasó y reentrenar cuando el negocio cambie.
- Cuidado con los datos personales. Si el modelo usa datos de clientes, aplican la Ley 29733 y su reglamento (D.S. 016-2024-JUS): finalidad, consentimiento y seguridad. Esta mención es informativa y no reemplaza asesoría legal.
Comprar o construir
Muchas herramientas ya traen machine learning incorporado: plataformas de anuncios, CRM, sistemas de recomendación de los ecommerce de catálogo, herramientas de correo. Conviene usarlas cuando el caso es estándar. Un modelo propio se entrena y se ejecuta normalmente en la nube, así que la migración a la nube suele ser un paso previo. Un modelo propio conviene cuando los datos y el proceso son específicos de tu negocio (tu forma de vender, tus clientes, tus productos) y la predicción alimenta un sistema tuyo. Ese modelo suele desarrollarse como parte de una aplicación empresarial integrada a tus datos, no como un experimento aislado.
Limitaciones que conviene conocer
- Un modelo aprende del pasado: si el mercado cambia, se equivoca hasta que se reentrena.
- Si los datos tienen sesgos, el modelo los repite.
- Las predicciones son probabilísticas; hay que decidir qué hacer con los falsos positivos y negativos.
- No sustituye el criterio del negocio: lo alimenta.
Qué hacer ahora
Elige una decisión que hoy tomas por intuición y que se repite (a quién cobrar primero, qué stock reponer, qué cliente está por irse), revisa si tienes historial de al menos un año y define cómo actuarías con una predicción. Si quieres evaluar si ese caso se puede resolver con machine learning integrado a tus sistemas, escríbenos por WhatsApp.
 hola@impulsastudio.pe
 933262820


